

Qui dit Coupe du Monde de football chez EURODECISION, dit incontournable concours de pronostics interne. En 2018, l’algorithme « LP-Pronos », basé sur des techniques d’optimisation et de statistiques, s’était illustré en décrochant le titre de vice-champion face à 21 collègues. Pour l’édition 2026, l’outil a repris du service au sein d’une ligue de 19 participants, avec un défi supplémentaire : mesurer notre modèle métier à quatre intelligences artificielles généralistes (ChatGPT, Gemini, Claude et Copilot).
Un démarrage chaotique : l’ironie du bug de conversion
Pour aborder cette nouvelle édition, LP-Pronos a fait sa mue technique : le code historique en VBA a été migré vers Python… à l’aide d’une IA. Une ironie du sort qui a coûté cher au démarrage. Un bug s’est glissé dans la conversion, faussant totalement les calculs sur les 10 premiers matchs et reléguant l’algorithme à une piteuse 16e place à l’issue de la première journée.
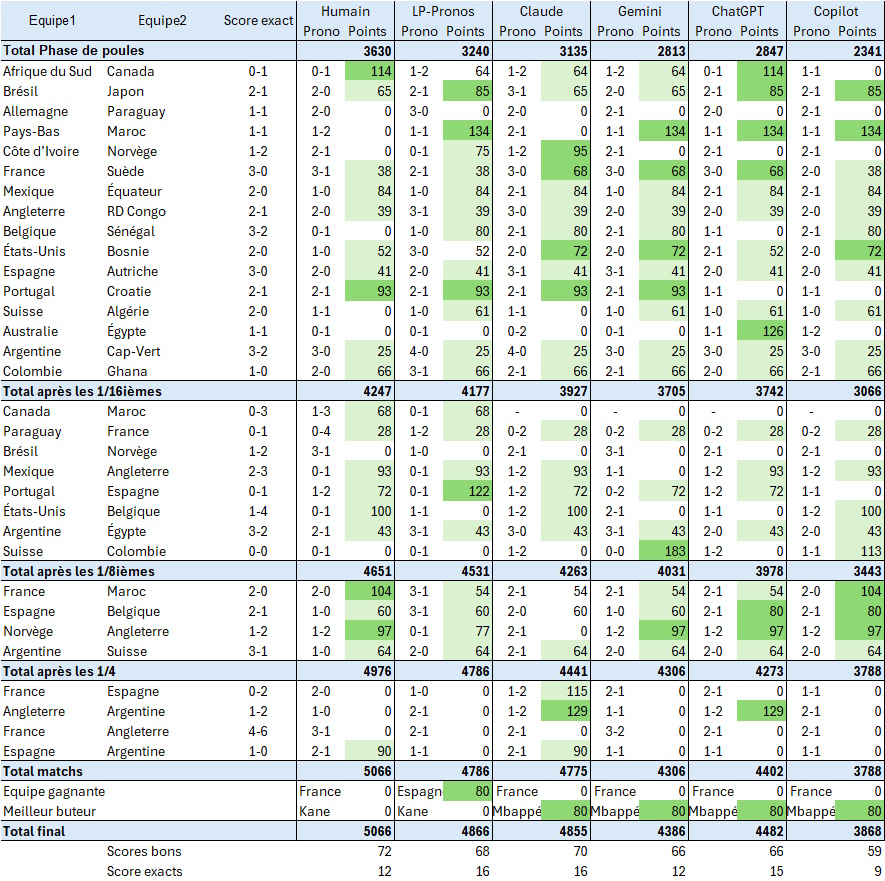
Une fois le correctif appliqué, LP-Pronos a pu enclencher une véritable « remontada », se hissant à la première place du classement sur l’ensemble des journées 2 et 3 de la phase de poules.
L’affrontement avec les modèles de langage
Tout au long du tournoi, deux philosophies se sont affrontées. D’un côté, les modèles de langage (LLM) ont souvent privilégié une stratégie de prudence en appliquant des scores gabarits (1-1, 2-1 ou 2-0). De l’autre, LP-Pronos s’est appuyé sur son approche statistique et de recherche opérationnelle, visant des scores exacts plus pointus.
Au sein du quatuor d’IA, Claude (Anthropic) s’est très vite détaché par sa finesse d’analyse, enchaînant les bons résultats tandis que Copilot, Gemini et ChatGPT peinaient à maintenir la cadence.
Un final à rebondissements : effondrement et coup de poker
À l’image de l’équipe de France sur le terrain, LP-Pronos a connu un passage à vide retentissant lors du dernier carré : zéro point engrangé sur les quatre derniers matchs. Claude en a profité pour réaliser un sprint final remarquable en anticipant les victoires de l’Espagne et de l’Argentine en demi-finales.
Le salut de LP-Pronos est venu d’une vision à long terme. LP-Pronos a été le seul participant de toute la ligue (humains et IA confondus) à avoir pronostiqué la victoire finale de l’Espagne. Ce bonus de 80 points lui a permis de sauver sa place sur le podium et de coiffer Claude pour seulement 11 petits points.
Le classement final et les enseignements
Au terme de la compétition, le verdict est tombé :
- 1er et 2e (Humains) : Le duo de tête humain signe un doublé (5 066 et 5 006 points). L’analyse fine du jeu et l’intuition conservent la couronne avec 72 bons résultats pour le vainqueur, qui, précisons-le, est un grand amateur de foot.
- 3e place (LP-Pronos) : Avec 4 866 points, notre algorithme décroche la médaille de bronze et partage le record de la compétition avec 16 scores exacts retrouvés.
- 4e place (Claude) : S’impose comme la meilleure IA avec 4 855 points (et 16 scores exacts), échouant aux portes du podium.
- 7e, 9e et 12e places (ChatGPT, Gemini et Copilot) : Les autres modèles de langage ferment la marche avec des performances plus en retrait.
Cette expérience démontre qu’un modèle statistique ciblé, conçu selon nos méthodes décisionnelles, conserve un avantage net sur des modèles de langage généralistes dès lors qu’il s’agit de prédiction chiffrée. Pour la prochaine coupe du monde en 2030, ces modèles généralistes auront surement énormément progressé et des modèles IA plus spécialisés en pronostics sportifs se développent de plus en plus. Mais nous avons sous le coude quelques idées d’amélioration de notre algorithme LP-Pronos afin qu’il reste en haut du classement !